工业互联网大数据数仓架构 赋能互联网数据服务的核心引擎
引言
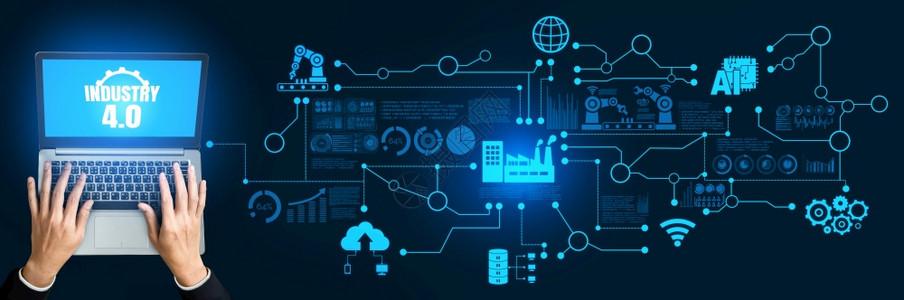
在工业互联网时代,数据已成为堪比土地、资本、劳动力的核心生产要素。工厂车间里的传感器、PLC、SCADA系统,供应链上的ERP、MES、WMS,以及来自互联网的用户行为、市场舆情,共同构成了海量、异构、实时性要求极高的数据海洋。如何将这些数据高效地采集、存储、计算并转化为可服务于业务决策的“互联网数据服务”,是工业企业数字化转型的关键。而支撑这一体系的核心,正是一套设计良好的工业互联网大数据数仓架构。
一、工业互联网数据的特点与挑战
与纯消费互联网数据相比,工业互联网数据具有鲜明特征:
- 海量且高频:单台设备每秒可产生数万条时序数据,一个中型工厂每天新增数据可达TB级。
- 多源异构:包含结构化(数据库表)、半结构化(JSON日志、XML)、非结构化(图像、音频、振动波形)数据。
- 强时序性:大部分数据带有时间戳,且时序数据的查询、聚合、降采样需求突出。
- 低延迟要求:设备监控、实时告警、预测性维护等场景需要毫秒到秒级的响应。
- 数据质量参差:传感器漂移、网络抖动导致缺失值、异常值普遍。
这些特点对传统数仓提出了巨大挑战,也推动了工业互联网大数据数仓架构的演进。
二、工业互联网大数据数仓分层架构
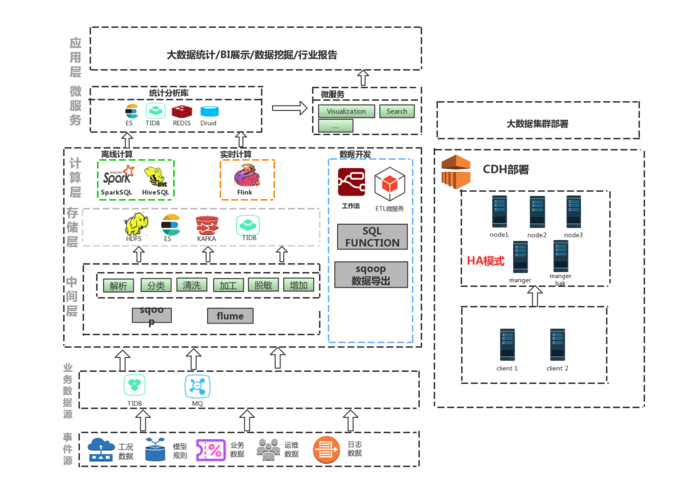
业界普遍采用分层设计,典型架构自下而上分为五层:
1. 数据采集与接入层
- 协议适配:支持Modbus、OPC UA、MQTT、HTTP等工业协议及Kafka、Flume等互联网协议。
- 边缘计算:在靠近设备侧进行数据预处理(过滤、降采样、格式转换),减轻云端压力。
- 数据接入:通过Kafka、Pulsar等消息队列实现高吞吐、低延迟的数据缓冲与解耦。
2. 数据存储与计算层(核心数仓层)
这是大数据数仓架构的主体,通常进一步细分为:
- ODS(原始数据层):贴源存储,保留原始数据,用于追溯和审计。可采用HDFS、对象存储、时序数据库(如TDengine、InfluxDB)。
- DWD(明细数据层):对ODS进行清洗、去重、规范化,形成统一的设备、物料、工单等事实表。常用Hive、Iceberg、Hudi。
- DWS(汇总数据层):按主题(设备、产线、能效)进行轻度聚合,生成宽表,提升查询性能。
- ADS(应用数据层):面向具体服务的高度汇总数据,直接对接API、报表、大屏。常用ClickHouse、Doris、StarRocks等OLAP引擎。
计算引擎需支持批流一体:Spark/Flink处理实时与离线任务,Presto/Trino用于交互式查询。
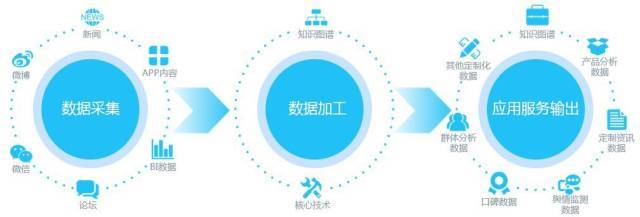
3. 数据服务层(互联网数据服务)
该层将数仓中的数据封装为标准化、可复用的互联网数据服务,对外提供:
- API服务:通过RESTful、GraphQL、gRPC暴露“设备状态查询”、“故障预测结果”、“OEE指标”等接口。
- 消息订阅:通过Kafka、WebSocket推送实时告警、工艺参数变更。
- 数据集市:面向不同业务域(生产、质量、供应链)提供自助式数据探索。
- 数据产品:如设备健康度看板、能耗优化APP、远程运维平台。
服务层需具备服务注册、发现、限流、熔断、鉴权、审计等能力,确保工业级可靠性。
4. 数据治理与安全层(贯穿各层)
- 元数据管理:统一管理技术元数据、业务元数据,支持数据血缘与影响分析。
- 数据质量:定义质量规则(完整性、准确性、一致性、及时性),实时监控与告警。
- 数据安全:分类分级、脱敏、加密、访问控制,满足等保及行业合规要求。
5. 运维与调度层
- 任务调度:Airflow、DolphinScheduler编排ETL/ELT流程。
- 资源管理:YARN、Kubernetes实现计算资源弹性伸缩。
- 监控告警:Prometheus + Grafana观测集群、任务、服务健康度。
三、技术选型示例(典型开源栈)
| 层级 | 组件选型 |
|------|----------|
| 采集 | Telegraf, EMQX, Filebeat |
| 消息 | Kafka, Pulsar |
| 存储 | HDFS, S3, Hudi, Iceberg, TDengine |
| 计算 | Flink, Spark, Presto |
| OLAP | ClickHouse, Doris, StarRocks |
| 服务 | Spring Boot, GraphQL, API Gateway |
| 治理 | Atlas, DataHub, Griffin |
| 调度 | Airflow, DolphinScheduler |
各企业可根据规模、实时性、成本灵活组合,亦可采用云上托管服务(如AWS IoT Analytics、阿里云DataWorks+MaxCompute)。
四、架构演进趋势
- 湖仓一体:以Iceberg/Hudi为表格式,统一数据湖与数仓,简化架构,支持增量更新与ACID。
- 流批一体:Flink SQL统一处理实时与离线,降低开发运维成本。
- DataOps:将DevOps理念引入数据管道,实现CI/CD、自动化测试、可观测性。
- AI增强:在数仓内嵌机器学习(如Flink ML、Spark MLlib),实现异常检测、预测性维护的闭环。
- 边缘-云协同:边缘进行实时推理与轻量数仓,云端进行全局训练与深度分析。
五、
工业互联网大数据数仓架构并非静态的模板,而是需要随业务需求、技术发展不断演进的有机体。其最终目标是打破数据孤岛,将沉睡的工业数据转化为敏捷、可靠、智能的互联网数据服务,从而驱动生产效率提升、商业模式创新与产业协同。对于正在数字化转型浪潮中的工业企业而言,构建一个分层清晰、治理完善、流批一体的数仓架构,是迈向数据驱动决策的必由之路。只有夯实这一数据底座,才能让工业互联网真正释放其巨大潜能。
如若转载,请注明出处:http://www.shandoubao.com/product/39.html
更新时间:2026-10-15 00:24:57